マルチモーダルAIとは?画像・音声・動画を扱う生成AIの仕組みと企業活用
生成AIの活用は、文章の作成や要約だけにとどまりません。資料の画像を読み取る、録音した会議の内容を整理する、動画から作業の流れを確認するなど、文字以外の情報を扱う場面にも広がっています。
こうした活用を支えるのが「マルチモーダルAI」です。企業にとっては、これまで人が目や耳で確認し、文章に置き換えていた作業を見直すきっかけになります。
本記事では、マルチモーダルAIの基本的な仕組みから、企業での活用方法、導入時の注意点までをわかりやすく解説します。
マルチモーダルAIとは?
文字・画像・音声など、複数の情報を扱うAI
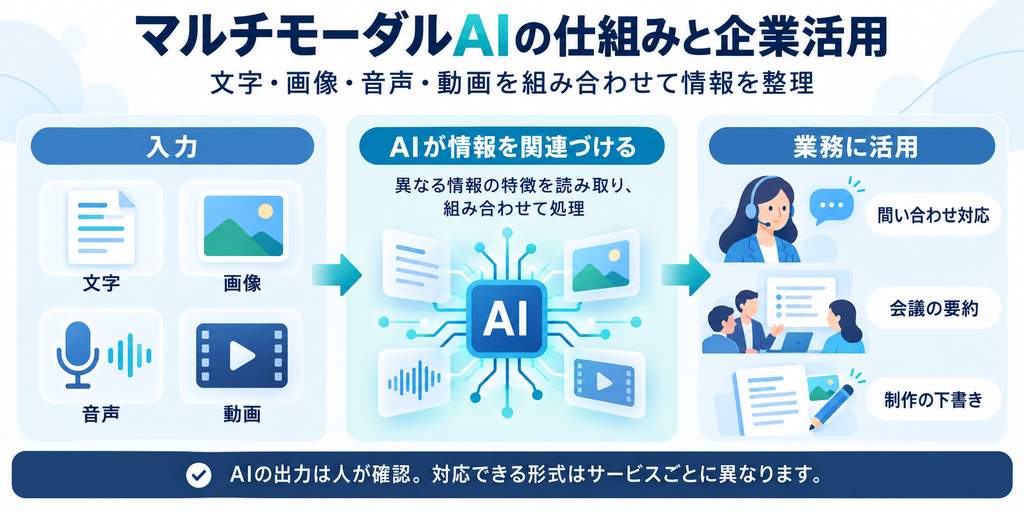
マルチモーダルAIとは、テキストや画像、音声、動画など、異なる種類の情報を組み合わせて処理するAIのことです。「モーダル」は情報の形式を指し、「マルチ」は複数を意味します。
例えば、商品の写真と「この商品の特徴を説明してください」という文章を入力すると、画像に写っている内容と質問を関連づけて回答します。利用する仕組みによっては、映像と音声の両方を手がかりに状況を整理することも可能です。
文章だけでは説明しにくい情報を、その形式のまま伝えられる点が特徴です。
生成AIとの違い
「生成AI」と「マルチモーダルAI」は、同じ意味ではありません。生成AIは文章や画像などを新しく作り出す能力に注目した呼び方であり、マルチモーダルAIは扱う情報の種類に注目した呼び方です。
文章だけを入力して文章を作る生成AIもあれば、画像と文章を入力して説明文を作るマルチモーダルな生成AIもあります。また、複数の情報を使って分類や判定を行うマルチモーダルAIもあります。
そのため、「マルチモーダルなら何でも生成できる」とは限りません。読み取れる形式と出力できる形式は、分けて確認する必要があります。
マルチモーダルAIの基本的な仕組み
情報を数値に変換し、関係性を捉える
AIは、写真や音声を人間と同じ感覚で理解しているわけではありません。基本的には、入力された情報を計算できる数値の表現へ変換し、学習したパターンを使って処理します。
その際、画像の特徴と説明文、映像の場面と音声など、異なる情報の関係を扱います。どの段階で情報を組み合わせるかはモデルによって異なりますが、複数の手がかりを関連づけることが重要になります。
例えば、商品の写真だけでは判断しにくい部分も、仕様書の説明を一緒に与えることで、回答の参考情報を補えます。ただし、情報が増えれば必ず正確になるわけではなく、資料同士に矛盾がないかも確認が必要です。
動画では映像と音声、時間の流れを扱う
動画の内容を把握するには、何が映っているかだけでなく、どの順番で出来事が起きたかを捉える必要があります。音声も扱える仕組みであれば、画面の変化と説明内容を関連づけて整理できます。
例えば、GoogleのGemini APIでは、動画の映像と音声を処理し、内容の説明や質問への回答に利用できます。ただし、動画の読み取り方法にはフレームの抽出などが関係するため、短い場面の見落としも考慮すべきです。
企業で利用する際は、「動画に対応しているか」だけでなく、必要な細かさで内容を確認できるかを検証しましょう。
企業におけるマルチモーダルAIの活用方法
以下は、企業で検討できる活用例です。実際に対応できる範囲は、利用するサービスや入力データによって異なります。
問い合わせ対応で状況を把握する
顧客からの問い合わせでは、文章だけでは状況が伝わりにくいことがあります。そこで、商品の写真やエラー画面と、顧客の説明文を組み合わせて確認する方法が考えられます。
例えば、サポート担当者が画像と問い合わせ内容をAIに入力し、確認すべき項目や返信文の下書きを作成します。「何が起きているのか」を整理する補助として使えば、初動対応の負担を減らせる可能性があります。
導入時は、AIだけで故障原因を断定する運用を避け、担当者が確認してから案内する流れにするとよいでしょう。
会議の録画から議事録や共有資料を作る
音声を扱うAIは、録音内容の文字起こしや要約に利用できます。さらに映像も扱える場合は、会議中に映された資料や画面の情報を踏まえた整理が活用候補になります。
例えば、「決定事項」「次回までの対応」「未解決の論点」に分けてまとめるよう指示すれば、社内共有用の下書きを作りやすくなります。
ただし、発言者の取り違えや、検討段階の話を決定事項としてまとめる誤りには注意が必要です。担当者名や期限は、元の記録と照合しましょう。
商品紹介や販促コンテンツの制作を支援する
商品画像と仕様書を組み合わせ、ECサイトの商品説明やSNS投稿文の下書きに活用する方法もあります。
例えば、画像から伝わるデザイン上の特徴と、仕様書に記載された素材・サイズを整理してから、用途に合う文章を作成します。先に情報をまとめる工程を設けると、制作担当者も内容を確認しやすくなります。
指示には「仕様書にない性能は追加しない」「画像だけで素材を断定しない」といった条件を入れましょう。見た目の印象と、確認済みの商品情報を区別することが大切です。
作業動画をマニュアル整備に役立てる
作業の様子を撮影した動画から、手順書のたたき台を作る活用も考えられます。担当者が動画を見直しながら一から文章を書く負担を減らすための使い方です。
例えば、動画内で確認できる操作を順番に整理させ、熟練者が注意点や判断基準を補足します。撮影されていない準備作業や、画面外で行った操作はAIでは確認できないため、人による追記が欠かせません。
マニュアルの完成を任せるのではなく、手順の洗い出しを支援させる設計が現実的です。
導入前に確認したい注意点
誤認識を前提に確認工程を設ける
マルチモーダルAIでも、画像や資料を正しく読み取れるとは限りません。視覚情報の正確な把握には課題があり、もっともらしい回答でも元の情報と食い違う可能性があります。
特に、金額・型番・数量などは、ひとつの誤りが業務に影響します。「読み取れない箇所は不明とする」「根拠となるページや時刻を示す」と指示し、人が確認しやすい出力に整えることが大切です。
入力する情報と利用条件を確認する
画像や録音には、顧客情報、社員の顔、社外秘の資料などが含まれる場合があります。アップロードする前に、業務上必要な情報だけに絞る運用を考えましょう。
サービス選定では、入力データの学習利用、保存期間、アクセス権限などを確認します。担当者ごとに判断が分かれないよう、利用できるサービスと入力できる情報を社内で整理しておくことも有効です。
小さな業務で費用対効果を確かめる
最初は、内容を確認しやすく、繰り返し発生する業務から試すと評価しやすくなります。
例えば、社内向け議事録の下書きに対象を絞り、作成時間だけでなく、修正時間や確認漏れも記録します。AIの処理が速くても、修正に手間がかかれば十分な効率化にはつながりません。
利用料金と確認作業を含めて比較し、効果を確かめてから対象を広げましょう。
まとめ
マルチモーダルAIは、文章・画像・音声・動画を組み合わせ、企業に蓄積された情報を活用するための技術です。問い合わせ対応、会議記録、販促制作、マニュアル整備など、さまざまな業務で活用を検討できます。
導入では、「どの情報を読み取らせるか」「何を出力させるか」「誰が確認するか」を明確にすることが重要です。まずは身近な業務で試し、人の確認まで含めた運用を整えることが、実用的なAI活用につながります。