ローカルLLMとは?企業がオンプレミスで生成AIを活用するメリットと注意点
生成AIを業務に取り入れたい一方で、「顧客情報や社内資料を外部サービスに入力してよいのか」と悩む企業は少なくありません。便利さだけでなく、情報の管理方法まで含めて導入を考える必要があります。
そこで選択肢となるのが、自社のパソコンやサーバーで動かす「ローカルLLM」です。社内で生成AIを利用できる環境を整えることで、機密情報を扱う業務にも活用の可能性が広がります。
ただし、自社環境で動かせば安全性や費用面の課題がすべて解決するわけではありません。本記事では、ローカルLLMの仕組みと企業での活用方法、導入前に押さえたい注意点を解説します。
ローカルLLMとは?オンプレミスとの関係
自社の端末やサーバーで動く大規模言語モデル
LLMは「Large Language Model」の略で、日本語では大規模言語モデルと呼ばれます。大量の文章データを学習し、質問への回答や文章の作成、要約などを行う生成AIの基盤技術です。
ローカルLLMは、こうしたモデルを手元のパソコンや自社管理のサーバーなどで実行する利用形態を指します。外部のAIサービスへ処理を依頼する構成とは異なり、入力内容をもとに回答を生成する処理を、自社側の環境で行います。
ここで区別したいのが「学習」と「実行」です。ローカルLLMの導入にあたって、必ずしもモデルを一から開発する必要はありません。公開済みの学習済みモデルなどを、自社環境で動かす方法もあります。
オンプレミスと閉域クラウドは異なる
オンプレミスとは、自社施設などに設置したサーバーや設備でシステムを運用する形態です。社内サーバーにLLMを導入すれば、オンプレミスで生成AIを利用する構成になります。
一方、専用ネットワークなどでアクセスを制限したクラウド環境は、オンプレミスとは区別されます。どちらも管理された環境を構築できますが、設備の設置場所や運用責任の範囲が異なります。
導入を検討する際は、「閉じた環境」という説明だけで判断せず、データの保存先と処理場所、管理担当者まで確認することが大切です。
企業がローカルLLMを活用するメリット
機密情報の処理場所を管理しやすい
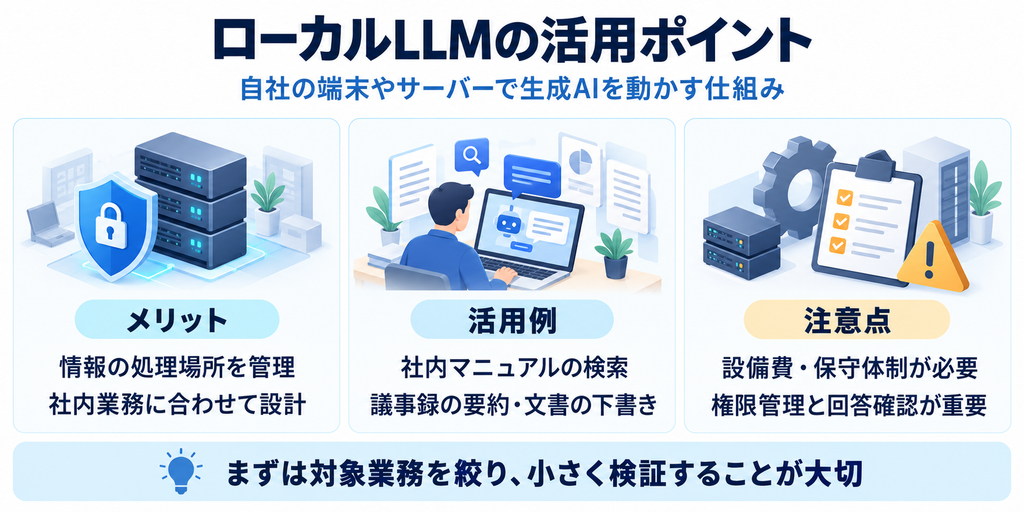
大きなメリットは、機密情報を外部のAIサービスに送信せずに処理する構成を選べることです。顧客情報、未公開の企画書、製品仕様書など、扱いに注意が必要な情報にも活用を検討できます。
ただし、LLM本体が社内にあっても、連携する検索機能や外部サービスがデータを送信する場合があります。ローカル実行に対応するOllamaでも、クラウド機能を無効化する設定が用意されています。社内完結を目指す場合は、周辺機能も含めて通信先を確認する必要があります。
社内業務に合わせた仕組みを構築できる
ローカルLLMは、社内システムや業務フローに合わせて設計できる点も特徴です。たとえば、問い合わせへの回答形式を統一したり、報告書の下書きを決まった書式で出力したりする使い方が考えられます。
社内資料を回答に利用する方法としては、RAGという仕組みがあります。RAGは、質問に関連する資料を検索し、その内容をLLMへ渡して回答を生成する方法です。モデルに追加学習を行わなくても、社内マニュアルなどを参照させられます。
なお、RAGや業務別の調整はクラウドでも利用できます。ローカルLLMの強みは、これらを自社管理の環境に組み込める点にあります。
利用規模に応じて費用を最適化できる可能性がある
大量の文章を継続的に処理する業務では、自社設備を使うことで、外部APIの従量課金を抑えられる可能性があります。
一方、サーバーの購入費や電気代、保守費用、担当者の人件費は必要です。利用量が少ない場合には、クラウドサービスのほうが低コストになることもあります。「モデルが無料で入手できること」と「業務システムを安く運用できること」は分けて考えましょう。
ローカルLLMが役立つ企業の業務
社内問い合わせへの回答と資料検索
就業規則や経費精算の手順、製品マニュアルなどを参照する社内チャットボットは、活用候補の一つです。従業員が自然な文章で質問できれば、複数の資料を探し回る負担の軽減につながります。
実務では、回答と一緒に参照資料を表示し、利用者が内容を確認できる設計が重要です。また、部署や役職によって閲覧可能な資料が異なる場合は、検索対象にも権限を反映させる必要があります。
記録の要約や文書の下書き作成
商談記録の要約、社内報告書の下書き、問い合わせ内容の分類なども、導入を検討しやすい業務です。人が内容を確認する前提で、文章を整理する工程の負担を減らせます。
実際にリコーは、那須赤十字病院へオンプレミスで稼働するLLMなどを提供し、退院サマリー作成業務を支援したと発表しています。機密性の高い情報を扱う現場で、文書作成を支援する活用例です。
一般企業でも、「最終判断を任せる業務」より、要約や下書きなど成果物を確認しやすい工程から検証すると、効果と課題を把握しやすくなります。
導入前に押さえたい注意点
必要な性能はモデルと利用条件で変わる
ローカルLLMに必要な設備は、モデルの規模や処理する文章の長さ、同時利用人数などによって変わります。小規模な検証では動いても、全社で利用すると回答待ちが増える可能性があります。
特にGPUという計算処理用の装置や、モデルを読み込むメモリの容量は、性能を左右する要素です。機器を先に購入するのではなく、実際の業務文書と想定人数で応答速度を確認し、必要な構成を決めることが重要です。
社内設置でもセキュリティ対策は欠かせない
外部への送信を抑えても、不適切なアクセス権限や端末の感染、管理ミスによる情報漏えいのリスクは残ります。利用者の認証、アクセス制御、ログの管理、ソフトウェアの更新まで含めた運用が必要です。
特に社内資料を検索する仕組みでは、本来閲覧できない情報が回答に含まれないように設計します。入力履歴や生成結果にも機密情報が残り得るため、保存期間と閲覧できる担当者を決めておきましょう。
回答の正確性とモデルの利用条件を確認する
ローカルLLMでも、事実と異なる回答を生成するハルシネーションは発生します。社内資料を参照するRAGを組み合わせても、誤りを完全には防げません。金額や日付、社内規定など、業務上重要な内容は原文と照合する運用が必要です。
また、公開されているモデルでも、商用利用や改変、再配布の条件は同じではありません。採用するモデルの利用条件を確認し、更新や障害対応を誰が担当するかも導入前に整理しておきましょう。
ローカルLLMは対象業務を絞って導入する
導入の第一歩は、AIを設置することではなく、改善したい業務を明確にすることです。「社内問い合わせの対応時間を減らす」「報告書の下書きを効率化する」など、効果を測れる目的を設定します。
そのうえで、小規模な検証を行い、回答の正確性、処理時間、人による修正の手間、運用費用を確認しましょう。生成にかかる時間だけでなく、確認まで含めた作業時間が短くなるかが判断のポイントです。
ローカルLLMは、データの管理と生成AIの業務活用を両立するための選択肢です。自社の情報管理方針と運用体制に合わせて、クラウドとの使い分けも検討することで、無理のない導入につなげられます。