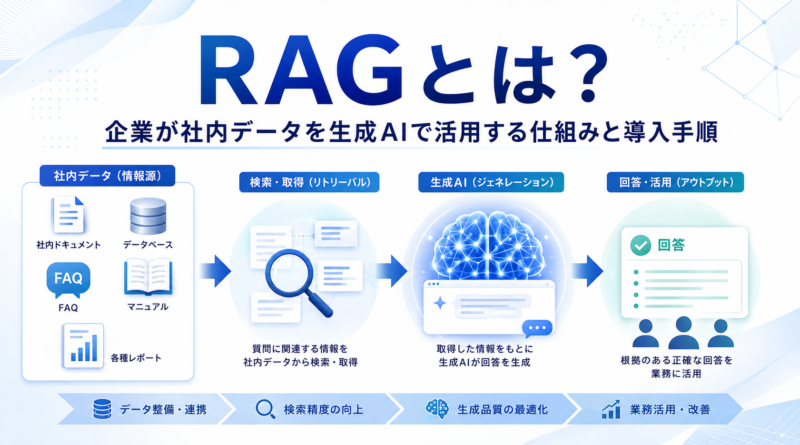
RAGとは?企業が社内データを生成AIで活用する仕組みと導入手順
ChatGPTやGeminiをはじめとした生成AIの企業活用が広がるなか、「一般的な質問には答えられるものの、自社の商品や社内ルールについては正確に回答できない」という課題を感じている企業も少なくありません。
そこで注目されているのが「RAG(ラグ)」と呼ばれる技術です。
RAGを活用すると、社内マニュアルや商品資料、FAQ、規程、過去の報告書などを生成AIが検索・参照し、その内容をもとに回答を作成できるようになります。
生成AIそのものを新しく学習させるのではなく、必要な情報をその都度検索して回答に利用できる点が特徴です。
この記事では、RAGの基本的な仕組みから企業で注目されている理由、活用例、導入手順、導入時の注意点までわかりやすく解説します。
RAGとは?
RAGとは「Retrieval-Augmented Generation」の略で、日本語では「検索拡張生成」と呼ばれます。
簡単に説明すると、生成AIが回答を作る前に外部のデータベースや社内資料を検索し、見つけた情報を参考にしながら回答する仕組みです。
通常の生成AIは、あらかじめ学習した情報をもとに文章を生成します。そのため、社内だけで使われているルールや非公開の商品情報、学習後に更新された情報などについては十分に回答できない場合があります。
RAGでは、こうした生成AIがもともと持っていない情報を必要に応じて検索し、回答を補強します。
通常の生成AIとの違い
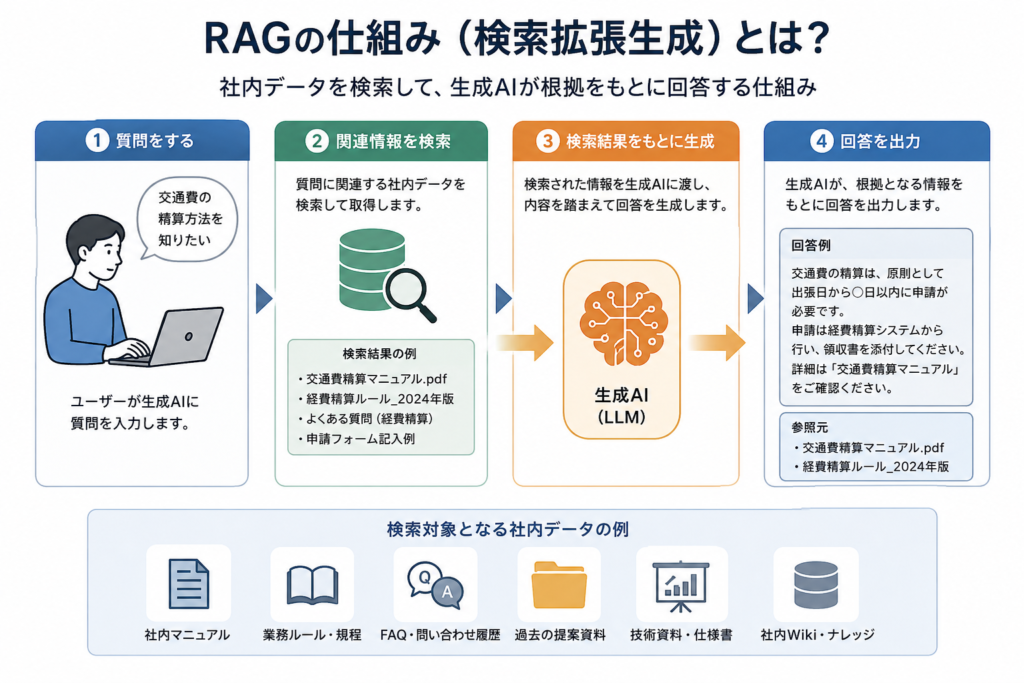
一般的な生成AIでは、ユーザーが質問すると、AIが学習済みの知識をもとに回答を生成します。
一方、RAGを組み合わせた生成AIでは、
「ユーザーが質問する」
↓
「関連する社内資料を検索する」
↓
「検索結果を生成AIに渡す」
↓
「資料の内容を踏まえて回答を作る」
という流れになります。
つまり、生成AIに「自社専用の検索機能」を組み合わせるイメージです。
これにより、汎用的な生成AIを企業独自のナレッジに対応したAIとして活用しやすくなります。
RAGの仕組み
RAGを理解するうえでは、「検索」と「生成」を分けて考えるとわかりやすくなります。
社内データを検索できる状態にする
まず、RAGで利用したい情報を準備します。
対象となるデータには、業務マニュアル、商品資料、社内規程、FAQ、議事録、技術資料、営業資料、社内Wikiなどがあります。
これらの文書をAIが検索しやすい単位に分割し、文章の意味を数値として表現する「ベクトル化」を行う方法が一般的です。
変換された情報は、ベクトルデータベースなどに保存されます。
質問に関連する情報を検索する
ユーザーが生成AIに質問すると、RAGシステムはデータベースから質問内容と関連性の高い情報を探します。
通常のキーワード検索とは異なり、文章の意味や文脈をもとに関連情報を検索できる方法も利用されています。
例えば、
「交通費の精算方法を知りたい」
と質問した場合、「経費精算」「交通費」「申請方法」などに関連する社内資料を検索します。
検索結果をもとに生成AIが回答する
検索によって取得した情報を生成AIに渡し、質問への回答を作成します。
このとき、生成AIは自身の知識だけに頼るのではなく、検索された社内情報を参考に回答します。
そのため、企業独自の制度や商品、業務ルールにも対応しやすくなります。
なぜ企業でRAGが注目されているのか
生成AIは文章作成や要約、アイデア出しなど幅広い用途で利用できます。
しかし、企業の実務で利用する場合、「正しい情報を回答できるか」という点が重要になります。
社内独自の情報を生成AIで扱える
企業には、インターネット上には公開されていない大量の情報があります。
例えば、社内ルール、製品仕様、過去の提案資料、顧客対応マニュアル、技術資料などです。
通常の生成AIはこうした情報を知らないため、企業固有の質問には正確に回答できません。
RAGを利用すれば、社内情報を検索対象として生成AIに参照させられるため、自社の業務に合わせたAI活用が可能になります。
ハルシネーションのリスクを抑えやすい
生成AIには、事実ではない内容をもっともらしく回答してしまう「ハルシネーション」が発生することがあります。
RAGでは、信頼できる資料を検索し、その内容を根拠として回答を生成させることで、推測だけによる回答を減らしやすくなります。
ただし、RAGを導入すれば誤回答が完全になくなるわけではありません。
検索した資料そのものが古かったり、関係のない資料が検索されたりすると、回答精度が低下する可能性があります。
RAGを企業で活用できる場面
RAGは特定の業種だけでなく、社内に情報が蓄積されているさまざまな企業で活用できます。
社内問い合わせ対応
RAGと社内チャットボットを組み合わせることで、従業員からの問い合わせ対応を効率化できます。
例えば、
・経費精算の方法
・休暇申請のルール
・社内システムの利用方法
・福利厚生の内容
・セキュリティに関する社内ルール
といった質問に、社内マニュアルを参照しながら回答できます。
人事や総務、情報システム部門への定型的な問い合わせを減らす用途にも向いています。
営業・マーケティング支援
過去の提案資料や商品情報、導入事例などをRAGの検索対象にすることで、営業担当者の情報収集を支援できます。
例えば、
「製造業向けの過去の提案事例をまとめて」
「A商品の特徴を顧客向けに説明して」
と質問すると、登録されている資料をもとに必要な情報を整理できます。
資料を探す時間を減らし、提案準備を効率化できる可能性があります。
カスタマーサポート
製品マニュアルやFAQ、過去の問い合わせ履歴などを参照させることで、問い合わせ対応にも活用できます。
担当者が複数の資料を探す代わりに、生成AIへ質問することで必要な情報をすばやく確認できます。
回答品質の均一化や、新人担当者の教育支援にもつながります。
技術・開発部門のナレッジ検索
技術仕様書や過去の障害報告書、設計資料などが大量に存在する企業では、必要な資料を探すだけでも時間がかかります。
RAGを利用することで、自然な文章で質問しながら関連資料を横断的に検索できるようになります。
RAGを導入するメリット
RAGの導入には、単なる情報検索以上のメリットがあります。
必要な情報を探す時間を削減できる
社内情報がファイルサーバーやクラウドストレージ、社内Wikiなど複数の場所に分散している企業では、情報探索そのものが大きな負担になります。
RAGを利用すれば、「どのフォルダにあるか」を把握していなくても、自然な言葉で質問して情報へアクセスしやすくなります。
社内ナレッジを共有しやすくなる
長年働いている社員だけが知っている業務知識や、特定部署だけが保有している資料は、企業にとって重要な資産です。
RAGによって情報を検索・活用できる環境を整えることで、個人や部署に偏ったナレッジを組織全体で利用しやすくなります。
モデルを再学習させず情報を更新できる
社内規程や商品情報は定期的に変更されます。
RAGでは検索対象となるデータを更新することで、新しい情報を回答に反映させられるため、生成AIモデルそのものを一から再学習させる必要はありません。
情報更新が多い企業にとって、大きなメリットとなります。
RAGを導入する手順
RAGは、最初から全社規模で導入するのではなく、対象業務を限定して段階的に進めることが重要です。
1. 解決したい業務課題を決める
まず、「生成AIを導入すること」ではなく「どの業務を改善したいのか」を明確にします。
例えば、
「社内問い合わせを減らしたい」
「マニュアル検索時間を短縮したい」
「営業資料を探しやすくしたい」
といった具体的な目的を設定します。
2. 利用する社内データを整理する
次に、RAGへ登録する資料を選びます。
データ量を増やせば必ず精度が高くなるわけではありません。
古い資料や重複した資料、誤った情報が含まれていると、検索精度や回答精度を下げる原因になります。
利用前に情報を整理し、信頼できるデータを選定することが重要です。
3. 小規模なPoCを実施する
PoCとは、本格導入する前に小規模な環境で効果や技術的な実現性を確認する取り組みです。
特定部署や特定業務に対象を絞り、
「必要な資料を検索できるか」
「回答内容は正確か」
「実際に業務時間を削減できるか」
などを確認します。
4. 回答精度を評価・改善する
RAGでは、生成AIの性能だけではなく「正しい情報を検索できるか」が非常に重要です。
検索対象となる文章の分割方法、検索件数、データの分類方法などを調整しながら精度を改善します。
実際の利用者から質問例を集め、継続的にテストすることも重要です。
5. 運用ルールを整えて本格導入する
一定の精度が確認できたら、対象部署や利用者を拡大します。
同時に、
「どのデータを登録するのか」
「誰が情報を更新するのか」
「どの情報までAIに参照させるのか」
といった運用ルールを決めます。
RAG導入時に注意したいポイント
RAGは便利な仕組みですが、導入するだけで高精度なAIシステムが完成するわけではありません。
データの品質を維持する
回答精度は、検索対象となる情報の品質に大きく左右されます。
同じルールについて新旧2種類のマニュアルが登録されていれば、古い内容を回答に利用してしまう可能性があります。
不要なデータを削除し、常に最新情報へ更新する運用が必要です。
アクセス権限を設計する
企業内のデータには、人事情報や顧客情報、経営情報など、閲覧できる従業員を限定すべき情報も存在します。
RAGを導入する場合も、ユーザーの権限に応じて検索・閲覧できる情報を制御する仕組みが重要です。
「社内データだからすべて登録する」のではなく、情報の機密性を考慮した設計が必要になります。
RAGだけで誤回答を完全には防げない
RAGはハルシネーションを抑えるために有効な手法ですが、完全に防止できるわけではありません。
重要な判断や顧客への正式回答などに利用する場合には、参照元を表示したり、人による確認を行ったりする仕組みも検討する必要があります。
RAGで生成AIを「自社の知識を活用できるAI」へ
生成AIを企業で活用するうえでは、一般的な知識だけでなく、自社が持つ情報をどのように活用するかが重要になります。
RAGを利用すれば、社内マニュアルや製品資料、FAQ、技術資料などを検索し、その情報を参考に生成AIが回答できる環境を構築できます。
社内問い合わせ対応、営業支援、カスタマーサポート、ナレッジ検索など、活用できる業務は幅広くあります。
一方で、RAGの精度は登録するデータの品質や検索方法、運用体制にも左右されます。
まずは対象となる業務とデータを限定してPoCを実施し、回答精度や業務改善効果を確認しながら導入範囲を広げていくことがポイントです。
生成AIを単なる文章生成ツールとして使うだけでなく、企業が蓄積してきた情報資産と組み合わせることで、より実務に適したAI活用へとつなげられるでしょう。
なお、「社内データを参照することで回答を根拠づけられる」「学習後の新しい情報や独自情報を扱いやすい」「RAGでも誤回答を完全には防げない」という部分は、Google CloudやAWSの現行公式資料とも整合しています。