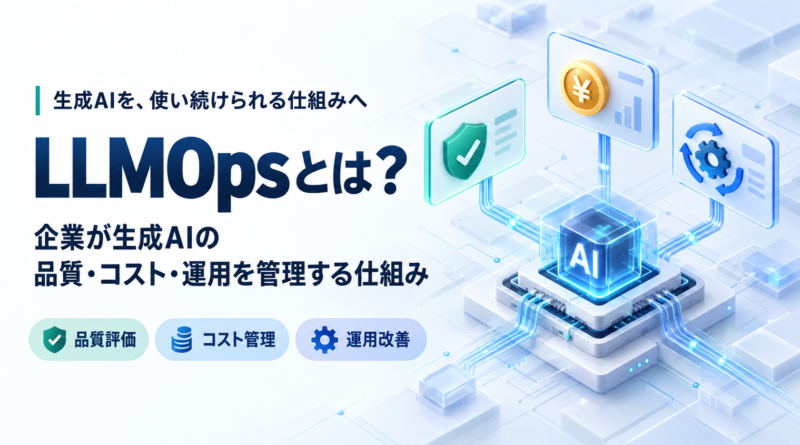
LLMOpsとは?企業が生成AIの品質・コスト・運用を管理する仕組みを解説
生成AIを使った社内チャットボットや文書作成システムは、導入して終わりではありません。利用が広がると、「回答の正確さにばらつきがある」「利用料金が想定を超える」「問題が起きても原因がわからない」といった課題が生まれます。
こうした課題に対応する考え方が「LLMOps」です。生成AIを業務で継続的に活用するには、便利さだけでなく、品質や費用、安全性を管理する仕組みが欠かせません。
本記事では、LLMOpsの基本から管理すべき項目、企業が運用体制を整える手順までを解説します。
LLMOpsとは?生成AIを継続的に運用するための取り組み
LLMOpsは「Large Language Model Operations」の略で、大規模言語モデルの開発・公開・監視・改善に関わる取り組みを指します。特定の製品名ではなく、LLMを安定して使い続けるためのプロセスや管理方法をまとめた概念です。Google Cloudも、モデル管理に加え、データ管理、評価、セキュリティなどを対象に挙げています。
企業が既存の生成AIモデルを外部サービス経由で利用する場合でも、運用管理は必要です。自社でモデルを一から学習させなくても、指示文の変更や参照資料の更新によって、回答品質は変わるためです。
例えば社内規程を案内するチャットボットでは、正しい資料を参照しているか、古い規程を回答していないか、閲覧権限のない情報を表示していないかまで確認する必要があります。
MLOpsとの違い
MLOpsは、機械学習モデル全般の開発と運用を管理する考え方です。LLMOpsはその中でも、大規模言語モデルに特有の課題を扱います。
生成AIでは、文章として自然でも、内容が正しいとは限りません。そのため、システムが正常に動いているかに加え、回答の根拠や指示への適合性なども評価する必要があります。
また、モデルだけでなく、プロンプトと呼ばれる指示文や、回答時に参照するデータも管理対象になります。
企業の生成AI活用でLLMOpsが必要になる理由
試験導入では問題がなくても、本番では質問の種類や利用人数が増えます。想定外の入力やアクセス集中によって、検証時には見えなかった問題が表面化することがあります。
さらに、業務マニュアルや商品情報が更新されても、生成AI側の参照情報が古いままでは、実務に合った回答を返せません。導入時の評価だけで、将来の品質まで保証することはできないのです。
Google Cloudの運用指針でも、本番環境での継続的な監視と、プロンプトやモデルの見直しによる改善が示されています。LLMOpsは、こうした改善を担当者の経験だけに頼らず、記録と評価に基づいて進めるための土台になります。
LLMOpsで管理する主な項目
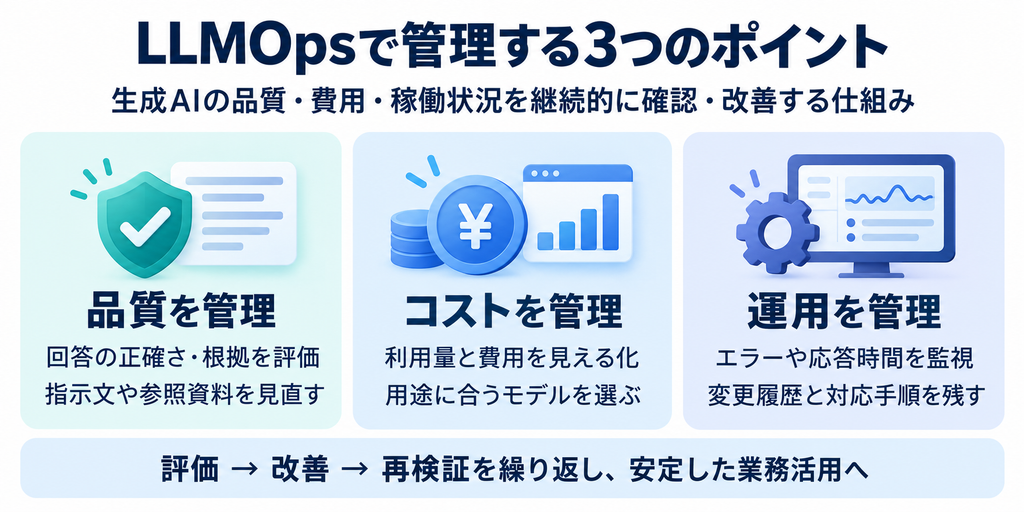
回答品質と業務への適合性
回答品質は、文章の読みやすさだけでは判断できません。事実に合っているか、必要な情報が含まれているか、根拠のない説明を加えていないかを確認します。
例えば問い合わせ対応なら「案内内容の正確さ」、議事録作成なら「決定事項や担当者の抜け漏れ」が重要です。業務ごとに評価基準を変えることで、実際の使いやすさを判断できます。
評価用の質問には、よくある質問だけでなく、条件が曖昧なものや回答できないものも含めます。不明な場合に無理に答えず、担当者への確認を促せるかも評価対象です。Google Cloudの評価サービスでも、評価用データや実際の利用ログを使った品質評価が想定されています。
利用コストと処理速度
費用を管理する際は、月額の合計に加え、どの部署・業務で利用が増えているかを把握します。API型サービスでは、入力・出力のトークン数などが費用に関係するため、利用件数だけでは増加の原因を説明できない場合があります。
トークンとは、モデルが文章を処理する際の単位です。長い資料や会話履歴を毎回送る設計では、1回あたりの処理量が増える可能性があります。
運用設計の例として、用途別に費用を集計し、単純な処理には軽量なモデルを使う方法が考えられます。ただし、費用を下げた結果、修正作業が増えては効果が薄れます。回答までの時間や人による確認工数も合わせて比較することが大切です。
プロンプトと参照データの変更履歴
指示文を修正した後、一部の質問には答えやすくなっても、別の質問で品質が落ちることがあります。変更前後を比較できるよう、プロンプトやモデル設定の履歴を残しましょう。
社内資料を検索して回答に利用するRAGを採用している場合は、参照資料の管理も必要です。RAGは、外部の情報を検索し、その内容を生成AIの回答に活用する仕組みです。
実務上は、どのモデル、指示文、資料の組み合わせで回答したかを追える状態にすると、不具合の切り分けに役立ちます。
セキュリティと利用記録
入力情報や回答には、顧客情報や社内の機密情報が含まれる可能性があります。利用者の権限、入力できる情報の範囲、記録の保存方法を決めておく必要があります。
利用記録を残す場合も、全文を無条件に保存する設計は避け、調査に必要な項目と保存期間を検討します。運用ルールの例として、個人情報を伏せる処理や、記録を確認できる担当者の限定が挙げられます。
企業がLLMOpsを導入する進め方
対象業務と合格基準を決める
最初は、効果を確認しやすい一つの業務に対象を絞ります。「社内問い合わせの回答案を作る」など、利用場面と生成AIに任せる範囲を明確にしましょう。
そのうえで、品質・費用・速度の基準を決めます。例えば、回答の正確さに加え、担当者が修正せず使える割合や、1件の処理にかかる費用を確認する設計です。
数値目標は一律に設定せず、誤回答が業務に与える影響や、現在の作業時間を踏まえて決めます。
小規模に運用し、改善につながる記録を残す
限られた利用者で運用を始め、質問内容、回答、処理時間、エラー、利用者の評価などを、必要な範囲で記録します。
例えば「回答が役に立たなかった」という評価だけでは、改善箇所がわかりません。情報不足なのか、資料が古いのか、指示文が曖昧なのかを確認できる記録が必要です。
あわせて、品質を確認する業務担当者、設定を変更する技術担当者、情報管理を判断する担当者の役割を決めておきます。
変更前に再評価し、公開後も監視する
モデルやプロンプト、参照資料を変更する際は、共通の評価用質問で変更前後を比較します。全体の評価が改善していても、重要な質問で問題が増えていれば、公開を見送る判断が必要です。
公開後に問題が起きた場合に備え、以前の設定に戻す方法や、一時的に人の対応へ切り替える手順も用意します。
改善案を試し、評価し、結果を確認する流れを繰り返すことが、安定した運用につながります。
LLMOpsは業務に合った管理体制から始めよう
LLMOpsを始めるために、最初から大規模な専用基盤を整える必要はありません。まずは評価用の質問、変更履歴、利用状況の記録、対応責任者をそろえることが出発点になります。
ツールを選ぶ際も、機能の多さだけでなく、自社の評価基準を設定できるか、費用の内訳を確認できるか、既存システムと連携できるかを確認しましょう。
生成AIを継続して業務に役立てるには、導入後の品質と費用を確かめ、問題を改善できる体制が必要です。自社の利用規模と業務上の重要度に合わせて、管理の仕組みを段階的に整えていきましょう。